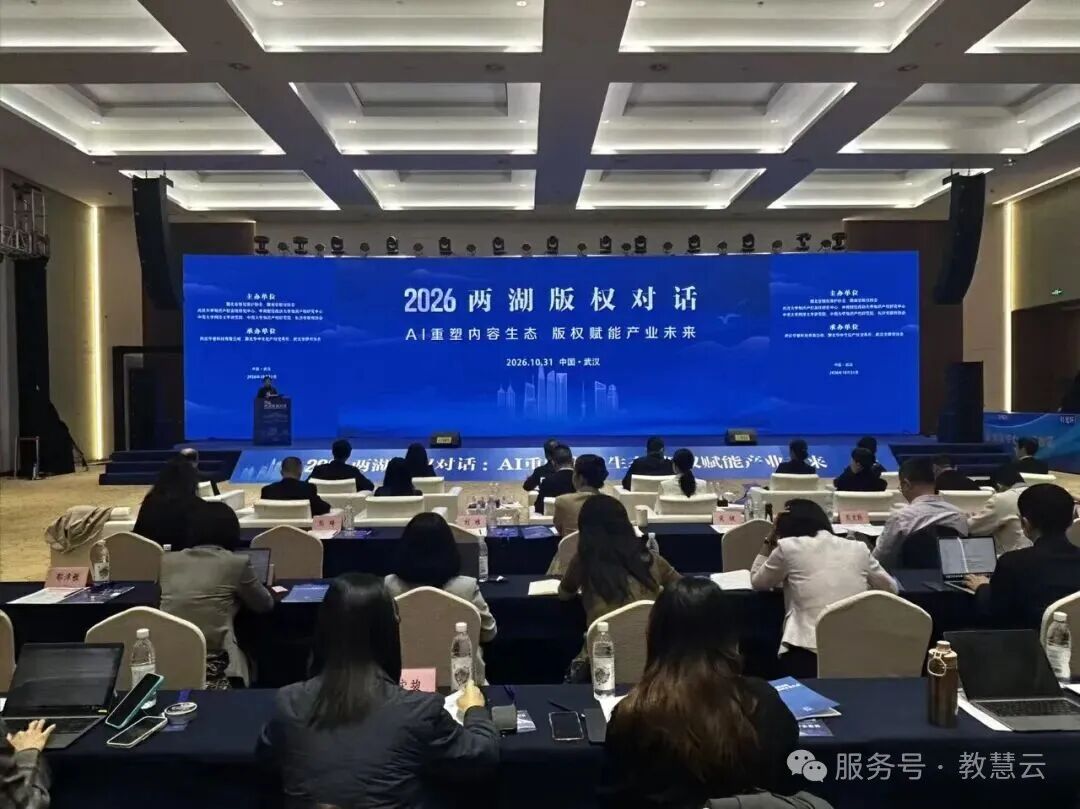
生成式 AI 高速普及,正在重构内容创作、分发传播与商业变现全链条,成为数字文化产业升级的核心驱动力。数据显示,截至 2025 年底,国内生成式 AI 用户规模已经突破 6 亿。新技术打开了产业的想象边界,也给沿用多年的版权体系带来巨大冲击,AI 生成物版权归属模糊、大模型训练数据合规存疑、平台责任边界难以界定等矛盾持续发酵。10 月 31 日,2026 两湖版权对话在武汉举办。近 300 名来自司法机关、高校学界、头部互联网平台、版权产业的从业者齐聚一堂,围绕 AI 对现有版权规则的挑战、新环境下的治理路径展开深度研讨。
“每一次技术革新,都会带动版权制度的深度变革。” 中南财经政法大学知识产权研究中心主任、中国知识产权研究会副理事长彭学龙在会上谈到,AIGC 早已走出实验室,成为各大平台常态化的内容供给方式,重塑数字内容生态。但在生产力爆发的背后,新的版权危机随之而来,最突出的矛盾集中在侵权批量爆发、平台责任边界不清两大问题。
借助 AI 工具,用户可以极低成本批量产出涉侵权内容,侵权体量呈爆炸式增长;权利人维权速度,远远追不上 AI 内容生成、扩散的速度。而 AI 平台手握生成工具、内容存储渠道与算法推荐能力,对内容流转拥有极强掌控力,却常常以 “技术中立” 为由主张免责,版权方和平台之间的利益失衡问题越来越突出。
参会专家一致认为,当下 AI 版权乱象的根源,落脚于两个尚未形成统一定论的核心问题:AI 生成内容能不能算作受保护作品、大模型未经许可海量使用原作训练,是否属于合法使用。
华东政法大学知识产权学院院长张本勇提出,判断 AI 生成物是否具备可版权性,必须严格依照法律标准。我国著作权法保护的作品,需要同时满足三个法定条件:具备独创性、属于智力成果的特定表达、由自然人创作。 AI 生成内容由模型参数、提示词输入、随机采样共同决定,提示词仅仅是输入条件之一,对最终产出的控制力有限;而且同一提示词在不同时间,输出结果也会存在差异。提示词和生成物之间缺少稳定、直接的因果联系,这也是 AI 内容很难被认定为 “创作成果” 的关键阻碍。 从域外实践来看,欧美主流国家的司法判例普遍不认可纯 AI 生成物享有版权。但有一种例外:如果自然人对素材筛选、编排结构、呈现形式做出带有独创性的个性化安排,这份汇编成果可以获得著作权保护,不过保护范围仅限编排方式,不覆盖里面的 AI 生成内容本身。
他还梳理出三类典型 AI 版权侵权情形:提示词直接植入原作侵权、使用特定作品训练小规模模型侵权、抓取海量作品训练通用大模型侵权。几类情形都适用 “接触 + 实质性相似” 的侵权判定标准。考虑到训练数据对大模型产业的战略价值,以及禁令对行业的巨大影响,司法在处理海量训练侵权案件时应当保持审慎,优先采用司法建议督促企业合规,而不是直接一刀切下禁令。
中宣部版权管理局原副局长段玉萍则聚焦大模型训练的合规争议。她指出,复制是模型训练的基础行为,而复制权是著作权人的核心权利。训练素材里包含大量受保护的文字、音乐、美术、影视、软件等作品,商业用途的 AI 训练,并不在现行著作权法列明的合理使用情形之内。 一旦将商业训练归入合理使用,等于无偿占用创作者的智力成果,损害权利人经济收益,长期会打击原创动力。她还梳理了海外最新判例:2026 年 7 月德国慕尼黑法院判决,OpenAI 未经许可使用协会管理的音乐作品训练模型,模型能够复现相关内容,认定训练行为构成侵权。美国、欧盟、英国等地司法也普遍持谨慎态度,不轻易认可商用训练的合法性,避免技术进步以牺牲创作者权益为代价。
面对层出不穷的新纠纷,湖北省荆州市中级人民法院代理院长严开元结合最高法 2026 年 9 月发布的《涉人工智能纠纷案件审理意见》,解读了当下的司法思路:我国暂时没有专门的人工智能单行立法,这份意见是在民法典、著作权法现有框架下,给出案件审理指引。 文件回应了归责原则、避风港规则、AI 换脸、逝者数字复刻等热点问题,但对AI 生成物可版权性、未经许可训练大模型定性这两大核心争议选择留白,模型蒸馏、智能体这类前沿新业态也没有覆盖,后续需要依靠指导性案例逐步细化规则。
这种留白不是法律空白,而是尊重技术迭代节奏。AI 技术、商业模式变化极快,产业形态还没有稳定成型,如果过早出台刚性条文,很容易快速滞后,反过来束缚技术创新。留白的意义,是留给行业协商空间,在版权保护和技术创新之间实现动态平衡。
百度集团 AI 产品法务负责人张青聚表示,技术创新和版权产业不是零和博弈,很多新矛盾可以依靠产业方案化解。法律规则影响深远,过重的责任要求,会对国内 AI 产业的国际竞争力造成冲击。 以搜索业务举例,百度每日承载数十亿次检索请求,海量并发场景下,全量事前审查并不具备可行性,强行前置过滤容易误伤大量合法信息,破坏信息流通。新规设计应当适配技术承载能力,兼顾公共信息利益和创新发展需求。
腾讯集团视频版权维权负责人谭乃文分享了影视行业的严峻现状:AI 内容爆发之下,盗版模式持续升级。仅 2026 年一季度,国内 AI 短剧、漫剧上新总量超 10 万部,日均上新超 1100 部。电视剧行业每年因盗版造成损失超 200 亿元,精品创作生态持续承压。 他提出,平台责任不能一概而论,要结合平台商业模式、内容管控能力、实际收益划分责任大小。短视频、视频平台早已不是单纯的技术存储方,深度参与内容筛选、编排、算法推荐,是侵权内容大范围扩散的重要推手。司法判决应当匹配版权价值、侵权情节和获利金额,倒逼平台主动开展侵权治理。
彭学龙提出,AI 时代的版权治理是系统性工程,需要搭建政府监管、平台自治、行业自律、社会监督的多元共治体系。监管层面完善标准、畅通纠纷快速处理通道;平台落地内部合规制度;行业协会制定自律公约;社会层面完善举报监督机制,多方合力维护版权生态。
同时他强调,过错责任依旧是适配 AI 时代的核心归责原则。AI 平台自主开发生成工具、依靠算法主动分发内容,对内容具备强控制力,传统 “技术中立” 的前提已经动摇;海量侵权内容也让传统 “通知 - 删除” 规则、红旗标准落地难度大增。平台责任需要从被动免责转向主动治理。 应当按照平台类型、技术能力、盈利模式设置分级注意义务,落实全流程主动管控,同时审慎适用连带责任,平衡创作者、平台、用户和 AI 产业各方利益,既保护版权,也为技术创新预留空间。
北京字节跳动法律研究院总监王洁同样支持差异化义务划分:模型开发主体重点管控训练数据源版权;AI 应用方负责生成内容标识、风险管控;传播平台做好标识核验、投诉处置。各方义务和知情程度、风险控制能力相匹配。 她介绍了字节的合规实践:Seedance2.0 大模型搭建标准化授权凭证机制,提升正版素材使用效率,配套侵权识别拦截系统;汽水音乐打造全链路 AI 音乐版权流程,做到内容来源可追溯。同时,完善投诉、反通知、申诉纠错闭环,打通平台快速处置、行业调解、行政调处、司法裁判的衔接通道,降低权利人维权成本。
严开元最后总结,AI 版权治理要守住三条底线:以人为本、鼓励创新、守住安全红线。知识产权法本身就是激励创新的法律,司法适用既要给 AI 产业发展空间,也要守住现有知识产权制度的基本框架。依靠法律解释、利益平衡思维灵活应对新问题,推动版权制度持续适配数字经济,让 AI 创新和版权保护共生共存。